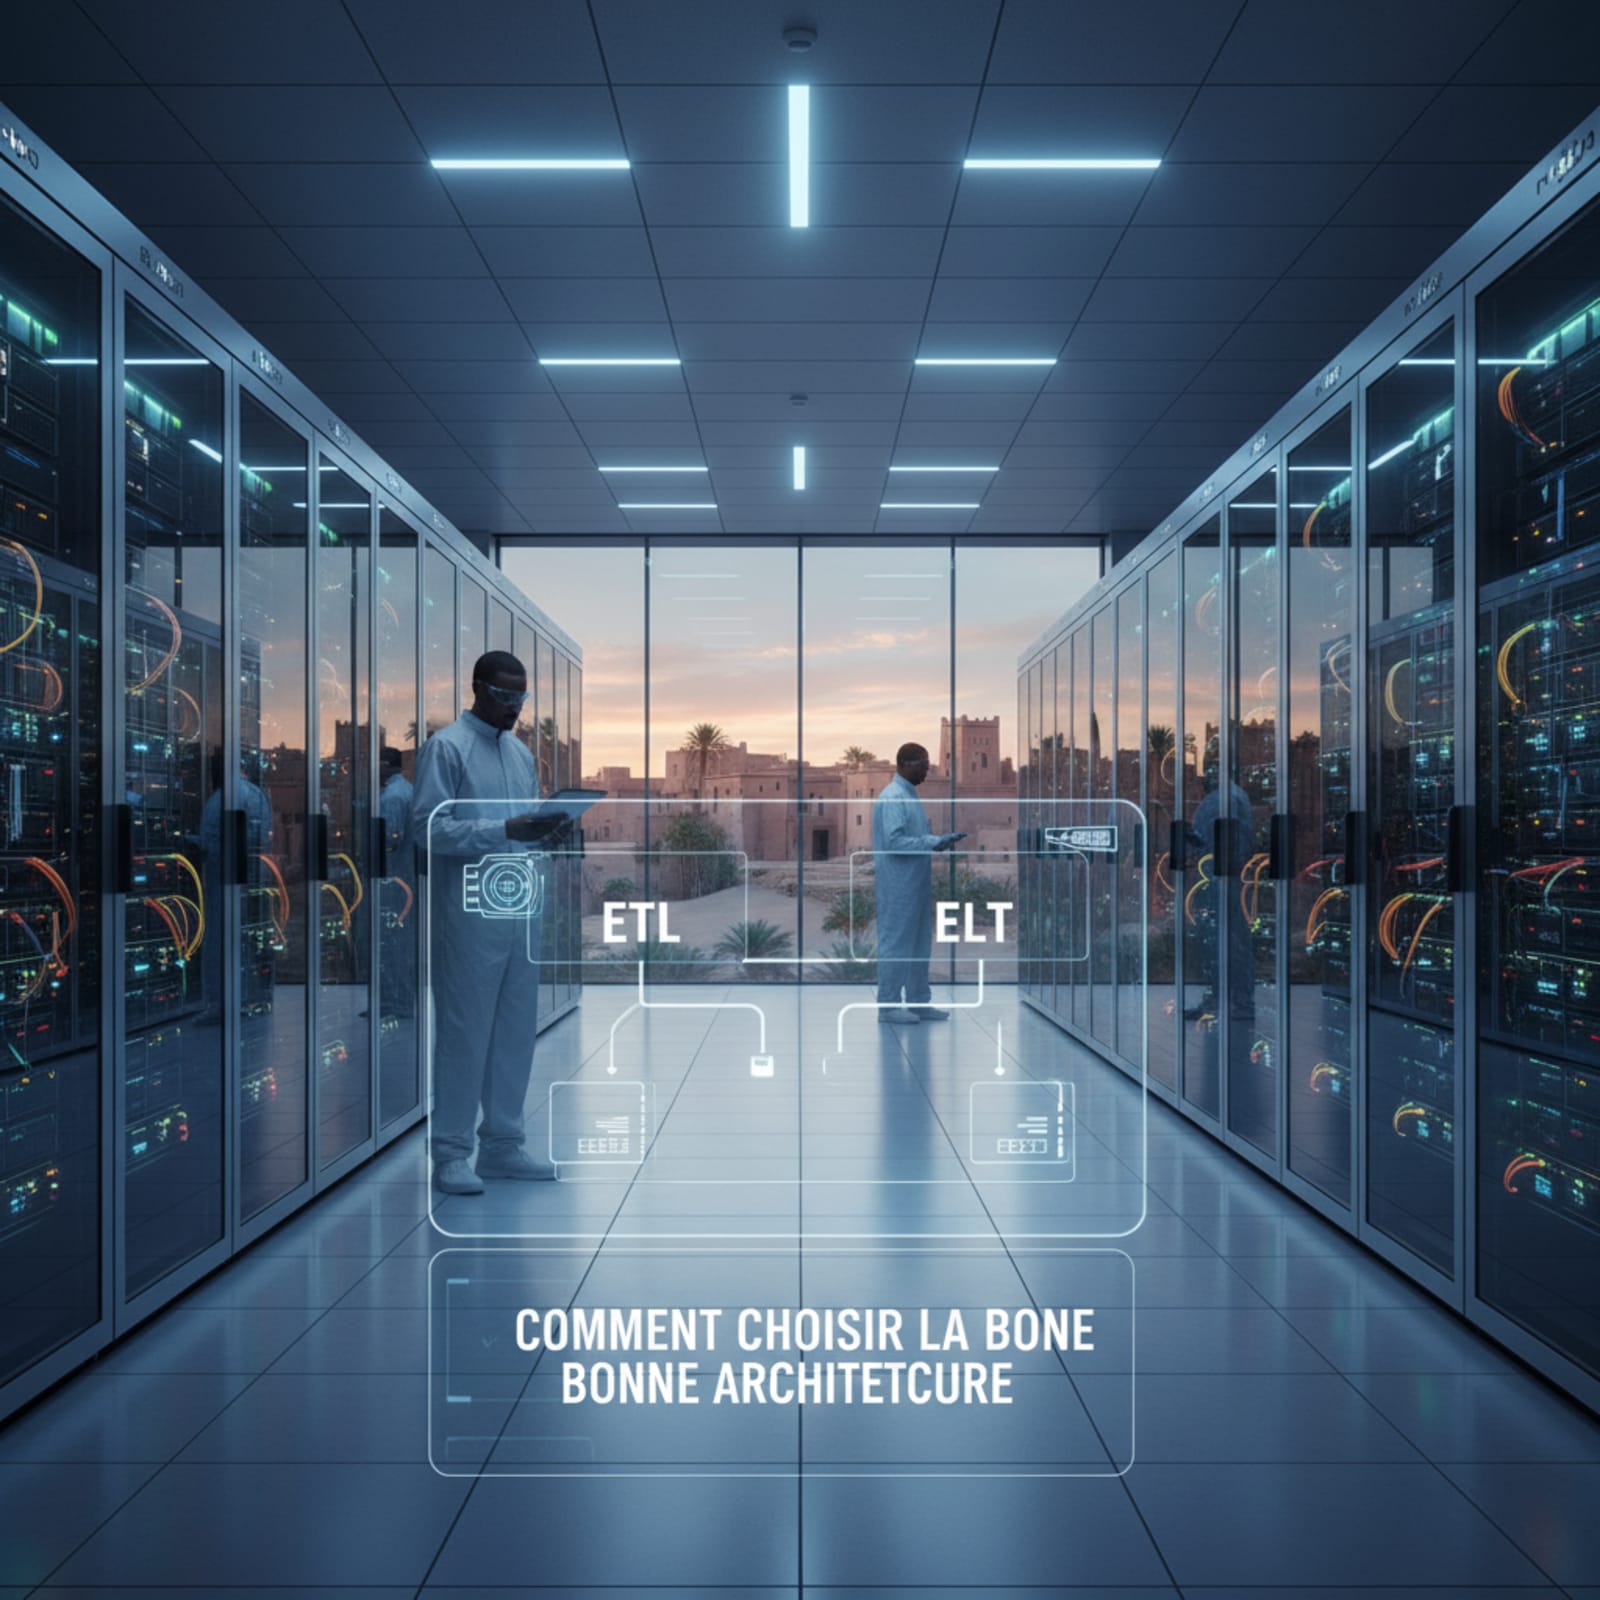
La différence majeure entre ETL et ELT réside dans le moment et le lieu où s'effectue la transformation des données. Dans l'ETL (Extract, Transform, Load), les données sont nettoyées sur un serveur intermédiaire avant d'être chargées dans l'entrepôt. Dans l'ELT (Extract, Load, Transform), les données brutes sont chargées directement dans l'entrepôt de données cloud, qui utilise sa propre puissance de calcul pour exécuter les transformations SQL ultérieurement.
- L'ETL convient aux infrastructures sur site (on-premise) avec des règles de conformité strictes.
- L'ELT exploite la puissance de calcul élastique des entrepôts de données cloud modernes.
- L'ELT offre une plus grande agilité en conservant l'historique complet des données brutes.
- Le choix d'architecture influence directement l'autonomie des analystes métiers face à la DSI.
Lors de la refonte d'un système décisionnel ou de la construction d'un nouveau pipeline de données, les décideurs marocains font face à un arbitrage technique majeur. Deux prestataires de services informatiques basés à Casablanca peuvent proposer deux approches diamétralement opposées pour répondre au même besoin de pilotage. L'un ne jure que par l'ETL traditionnel tandis que l'autre pousse vers une architecture ELT moderne et cloud. Pour une direction des systèmes d'information ou une direction financière, ce choix n'a rien d'anodin car il impacte directement les coûts d'infrastructure, la rapidité d'accès aux rapports de performance et l'autonomie des équipes métiers. Comprendre la différence fondamentale entre ces deux philosophies de traitement de l'information s'avère indispensable avant de valider un investissement technologique structurant.
Deux sigles, deux philosophies
Pour clarifier le débat, il convient de décomposer les trois étapes clés de l'intégration de données qui composent ces acronymes. La lettre E désigne l'extraction, c'est-à-dire la récupération des données brutes depuis vos différentes sources comme votre ERP, votre CRM, vos fichiers comptables ou vos bases de données de production. La lettre T représente la transformation, qui englobe le nettoyage, le formatage, la déduplication et l'application des règles de gestion métier pour rendre la donnée exploitable. Enfin, la lettre L correspond au chargement, qui consiste à stocker ces données prêtes à l'emploi dans une base de destination finale dédiée à l'analyse.
La différence cruciale entre ETL vs ELT réside simplement dans l'ordre d'exécution de ces étapes et dans le lieu où s'effectue la transformation. Dans un schéma ETL, la transformation a lieu dans un serveur intermédiaire dédié avant que les données n'atteignent l'entrepôt final. À l'inverse, le modèle ELT charge d'abord les données brutes directement dans l'entrepôt de destination et utilise la puissance de calcul de ce dernier pour effectuer toutes les transformations nécessaires. Ce déplacement de la phase de transformation modifie profondément la dynamique de vos projets d'intégration de données.
L'ETL classique et ses contraintes
L'approche ETL historique est née à une époque où le stockage et la puissance de calcul des bases de données de destination coûtaient extrêmement cher. Pour éviter de saturer le serveur décisionnel avec des opérations de calcul lourdes, on a créé un serveur intermédiaire, souvent appelé serveur de staging, pour exécuter toutes les règles de transformation. Cette méthode garantit que seules des données parfaitement propres, structurées et agrégées entrent dans l'entrepôt de données final. De grands acteurs de la distribution ou de l'industrie au Maroc utilisent encore ces flux hautement sécurisés pour consolider leurs rapports financiers mensuels.
Cependant, cette architecture traditionnelle présente des limites de taille face à l'explosion des volumes de données. La création d'un pipeline de données sous forme d'ETL rigide demande un temps de développement initial conséquent. Chaque modification d'une règle de gestion ou l'ajout d'une nouvelle colonne nécessite l'intervention d'un ingénieur spécialisé pour modifier le schéma intermédiaire. De plus, le serveur de staging représente un goulot d'étranglement technique. Si le volume de données quotidiennes double subitement, le traitement peut déborder sur les heures de bureau et ralentir l'accès aux tableaux de bord décisionnels.
L'ELT et la bascule vers le cloud
La démocratisation du cloud computing et l'émergence des entrepôts de données modernes comme Snowflake, Google BigQuery ou Amazon Redshift ont totalement redéfini la donne. Ces technologies modernes offrent une puissance de calcul et de stockage quasi illimitée qui peut s'adapter instantanément à la demande. C'est dans ce contexte technologique que l'ELT a pris tout son sens. Puisque l'entrepôt de destination est désormais extrêmement puissant et capable de traiter des téraoctets de données en quelques secondes, pourquoi s'embêter avec un serveur intermédiaire coûteux et complexe à maintenir ?
Avec l'ELT, on extrait les données de toutes les sources de l'entreprise et on les charge immédiatement, sous leur forme brute ou semi-structurée, dans l'entrepôt de données centralisé. Les transformations se font ensuite directement au cœur de cet entrepôt en utilisant le langage SQL. Cette approche permet de conserver l'historique complet des données brutes. Si vos analystes décident dans six mois de modifier la méthode de calcul de la marge commerciale, ils n'ont pas besoin de reconstruire tout le pipeline de données depuis la source. Il leur suffit de réappliquer une nouvelle requête SQL sur les données brutes déjà stockées dans le cloud.
Ce que le choix change pour les équipes
Au-delà de l'aspect purement technique, l'arbitrage entre ETL et ELT transforme le quotidien de vos collaborateurs. Dans une configuration ETL classique, les analystes métiers dépendent entièrement de l'équipe informatique ou du prestataire externe pour la moindre évolution des rapports. Si la direction marketing d'une grande enseigne comme Marjane Holding ou Label'Vie souhaite croiser les données de fidélité avec une nouvelle campagne publicitaire digitale, elle doit formuler une demande d'évolution technique qui peut prendre plusieurs semaines à se concrétiser.
L'ELT favorise une culture de la donnée beaucoup plus agile et décentralisée. Les ingénieurs de données se concentrent uniquement sur la tuyauterie en garantissant que les données brutes arrivent de manière fiable et sécurisée dans l'entrepôt. Une fois les données disponibles, les analystes métiers et les contrôleurs de gestion peuvent prendre le relais. En utilisant des outils de transformation modernes et collaboratifs basés sur SQL, ils créent eux-mêmes leurs propres tables de données nettoyées et leurs indicateurs clés de performance, réduisant ainsi considérablement le délai de mise à disposition des analyses stratégiques.
Trancher selon la volumétrie et les compétences
Le choix final ne doit pas être dicté par une simple tendance technologique, mais par une analyse pragmatique de votre contexte d'entreprise. L'ETL traditionnel reste une excellente option si vous manipulez des volumes de données stables, hautement confidentiels, et que vous possédez déjà des infrastructures sur site performantes. Il est également privilégié lorsque des règles de conformité strictes imposent de masquer ou d'anonymiser des données sensibles avant même qu'elles ne quittent les serveurs de production locaux.
En revanche, si votre entreprise est engagée dans une transition vers le cloud, qu'elle gère des volumes de données croissants et changeants, et qu'elle cherche à donner plus d'autonomie à ses équipes analytiques, l'ELT s'impose naturellement. Pour réussir cette transition technologique complexe et concevoir une architecture de données performante et évolutive, l'accompagnement par des experts en ingénierie de données s'avère indispensable. Les consultants de Data Scale Business vous aident à concevoir, sécuriser et déployer des pipelines de données modernes parfaitement adaptés aux réalités économiques et opérationnelles de votre organisation.